What Is Hybrid AI ? How Combining Cloud and Edge Architecture Optimizes.
ملخص سريع
- يجمع الذكاء الاصطناعي الهجين بين الذكاء الاصطناعي المحلي على جهازك (Edge AI) والذكاء الاصطناعي السحابي (Cloud AI) ضمن نظام كمبيوتر واحد لإدارة مختلف أنواع أعباء العمل بسلاسة.
- يستفيد من مزايا كلا البنيتين لمنع تسرب البيانات، والقضاء على المخرجات غير المستقرة، وتحسين ميزانية خدمات السحابة الخاصة بك.
- يوفر خيارات مرنة لنماذج اللغة الكبيرة (LLM)، مما يسمح للمستخدمين بنشر النموذج المناسب دائمًا لمهامهم المحددة.
في مقالنا السابق، قدمنا ما يمكن أن يفعله أجهزة الكمبيوتر الشخصية المزودة بالذكاء الاصطناعي التنفيذي (Agentic AI PC) واستكشفنا حالات استخدامه في حياتنا اليومية. كما ناقشنا كيف يمكن للذكاء الاصطناعي التنفيذي العمل في بيئات الذكاء الاصطناعي المحلي على جهازك والذكاء الاصطناعي السحابي. يقدم كل نهج أداءً ونتائج رائعة، ولكن لكل منهما قيوده الخاصة. وهنا يأتي دور الذكاء الاصطناعي الهجين ليقدم حلاً جديدًا يساعد على تحقيق التوازن المثالي بين المحلي على الجهاز والسحابي. دعونا نلقي نظرة فاحصة على سبب حاجتنا إلى الذكاء الاصطناعي الهجين وكيف يمكنه تقديم أفضل ما في العالمين.
لماذا نحتاج إلى الذكاء الاصطناعي الهجين؟
يقدم الذكاء الاصطناعي السحابي قدرات حوسبية أقوى بكثير، مما يعني أنه يمكنه تقديم نتائج رائعة والتعامل مع أعباء عمل أكثر تعقيدًا وتطلبًا. ومع ذلك، غالبًا ما يأتي ذلك بتكاليف إضافية، مثل رسوم الاشتراك أو تكاليف واجهة برمجة التطبيقات (API) لخدمات الذكاء الاصطناعي.
علاوة على ذلك، لا يمكن التعامل مع جميع أنواع الأسئلة أو المهام عبر الذكاء الاصطناعي السحابي؛ فقد تكون بعض المهام أو الطلبات مقيدة بسبب اللوائح التنظيمية أو مخاوف الخصوصية أو متطلبات محددة أخرى. وتعد خصوصية البيانات إحدى أكبر هذه المخاوف، حيث قد يتم معالجة بيانات المستخدمين أو استخدامها من قبل مزودي خدمات الذكاء الاصطناعي لتطوير نماذجهم.
مشكلة أخرى تتمثل في أن نماذج الذكاء الاصطناعي عبر الإنترنت يتم تحديثها أو تعديلها باستمرار. نتيجة لذلك، قد تتغير الإجابات الموفرة بمرور الوقت، مما يجعل من الصعب ضمان أن نفس السؤال سينتج دائمًا نفس النتيجة أو أن الإجابة ستبقى دقيقة ومستقرة.
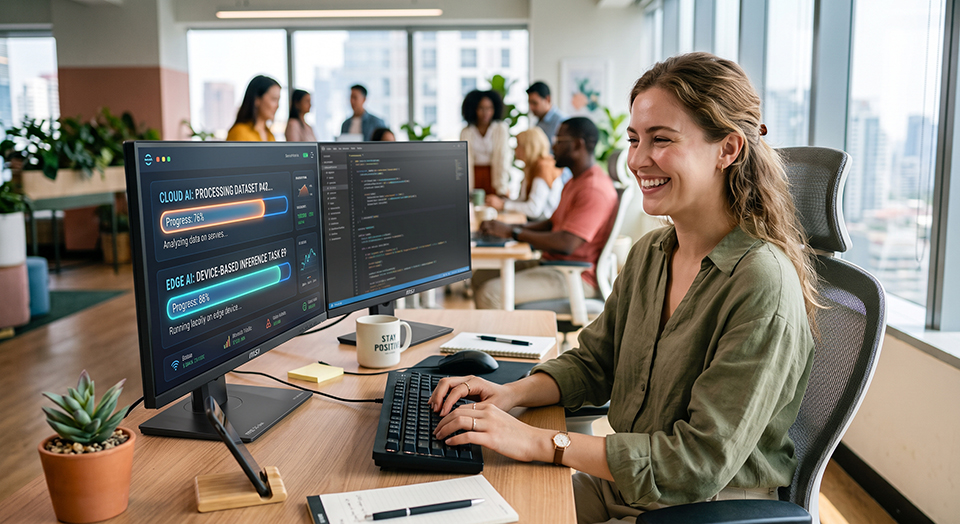
في المقابل، يقدم الذكاء الاصطناعي المحلي على جهازك (Edge AI) نهجًا مختلفًا تمامًا عن الذكاء الاصطناعي السحابي. قد لا يقدم دائمًا نفس مستوى النتائج التي يقدمها نموذج قوي قائم على السحابة، ولكنه يوفر العديد من المزايا المهمة: فلا يحتاج المستخدمون إلى دفع رسوم اشتراك إضافية لخدمات السحابة، كما تبقى بياناتهم على الجهاز مما يقلل من مخاطر تسرب البيانات. بالإضافة إلى ذلك، توفر نماذج الذكاء الاصطناعي التي تعمل محليًا بيئة أكثر قابلية للتنبؤ والتحكم، مع منح المستخدمين مرونة أكبر في المهام والأسئلة التي يرغبون في معالجتها.
من خلال الجمع بين مزايا كلا النهجين وتعيين المهام المناسبة بذكاء للخدمة الملائمة، يمكننا تعظيم أداء جهاز الكمبيوتر الشخصي المزود بالذكاء الاصطناعي التنفيذي.
على سبيل المثال، يمكن إسناد المهام الأكثر تطلبًا إلى الذكاء الاصطناعي السحابي للاستفادة من قوته الحاسوبية العالية، بينما يمكن التعامل مع المهام اليومية والحساسة للخصوصية مثل الترجمة والتلخيص والوظائف المجدولة ومعالجة البيانات الشخصية بواسطة الذكاء الاصطناعي المحلي.
يمكننا أيضًا استخدام الذكاء الاصطناعي المحلي لتبادل الأفكار وتطوير المفاهيم الأولية، ثم الاستفادة من الذكاء الاصطناعي السحابي لتحويل تلك الأفكار إلى نتائج أكثر تطورًا ودقة. ومن خلال التعامل مع المراحل الأولية محليًا، يمكننا تقليل الاستخدام غير الضروري للسحابة وتوفير التكاليف والرموز (Tokens)، مع الاستفادة من القوة الحاسوبية الكبرى للسحابة عند الحاجة الفعلية إليها.
من خلال التأكد من استخدام كل مورد حاسوبي بحكمة، يمكننا تحقيق توازن أفضل بين الأداء والتكلفة والخصوصية والمرونة.
استثمار كل مورد في مكانه الصحيح
من خلال الاستفادة من إمكانيات الذكاء الاصطناعي السحابي، يمكننا توجيه المهام عالية القيمة والمكثفة حوسبيًا إلى السحابة، بينما نترك للذكاء الاصطناعي المحلي على جهازك مهمة التعامل مع أعباء العمل العامة واليومية.
يمكن للذكاء الاصطناعي السحابي إنشاء برامج أو لوحات تحكم عالية الجودة لتحليل البيانات. وبمجرد تطوير البرنامج، يمكننا استخدام وكيل الذكاء الاصطناعي لاستيراد البيانات الحساسة أو السرية وإجراء التحليل محليًا. بهذه الطريقة، تبقى البيانات الحساسة آمنة على الجهاز، مما يقلل من مخاطر التعرض والتسريب.
هذا النهج يشبه مفهوم الاستعانة بمصادر خارجية لتطوير البرمجيات؛ حيث يساعدنا الذكاء الاصطناعي السحابي في بناء الأدوات التي نحتاجها، بينما يتولى الذكاء الاصطناعي المحلي معالجة البيانات الحساسة والتحليل الفعلي محليًا. ومن خلال الجمع بين نقاط القوة لكليهما، يمكننا الاستفادة القصوى من موارد الذكاء الاصطناعي المتاحة مع الحفاظ على أعلى مستويات التحكم في خصوصية البيانات وأمنها.
استخدام نموذج اللغة (LLM) المناسب لكل مهمة
يمكن للذكاء الاصطناعي السحابي المساعدة في الإجابة على العديد من الأسئلة والتعامل مع مجموعة واسعة من المهام. ومع ذلك، قد لا تمكنه اللوائح أو السياسات أو القيود الأخرى من الإجابة على كل طلب. وقد لا تتلقى دائمًا إجابة كاملة، أو قد يتم رفض بعض الطلبات من قبل خدمات السحابة. في المقابل، يوفر الذكاء الاصطناعي المحلي مرونة أكبر لأن النماذج التي تعمل محليًا لا تخضع لنفس القيود والسياسات الصارمة المفروضة على خدمات السحابة.
في هذه الحالات، يمكننا البحث عن نموذج لغة كبير (LLM) مناسب على منصة Hugging Face يلبي احتياجاتنا المحددة وتشغيله محليًا على جهاز AI PC. وتعد منصة Hugging Face بيئة مفتوحة توفر الوصول إلى مجموعة واسعة من نماذج الذكاء الاصطناعي مفتوحة المصدر والمتاحة للاستخدام في تطبيقات مختلفة، مثل Ollama أو Bionic.
لمزيد من المعلومات حول أجهزة الكمبيوتر المكتبية الذكية من MSI، يرجى زيارة الرابط التالي للحصول على التفاصيل الكاملة:
https://www.msi.com/Business-Productivity-PCs
https://www.msi.com/Business-Productivity-PCs
في مجالات البحث والتطوير، يمكننا استخدام نماذج اللغة المحلية لدراسة وتحليل البرامج التي نحتاجها، ثم استخدام خدمات الذكاء الاصطناعي السحابية للمساعدة في تطوير المنتج النهائي وتحسين جودته. وكما ذكرنا سابقًا، قد يتم تقييد بعض الطلبات بواسطة خدمات السحابة؛ وفي مثل هذه الحالات، يمكننا استخدام نموذج لغة محلي على الجهاز لتحليل الكود البرمجي، وتحديد المشكلات المحتملة، وتطوير الكود أو تحسين المنتج بشكل أكبر.
من خلال الجمع بين نقاط القوة للذكاء الاصطناعي المحلي على الجهاز والسحابي، نعلّي من مرونة عملية التطوير ونحقق أفضل النتائج.
كيف نختار جهاز كمبيوتر ذكاء اصطناعي تنفيذي (Agentic AI PC)؟
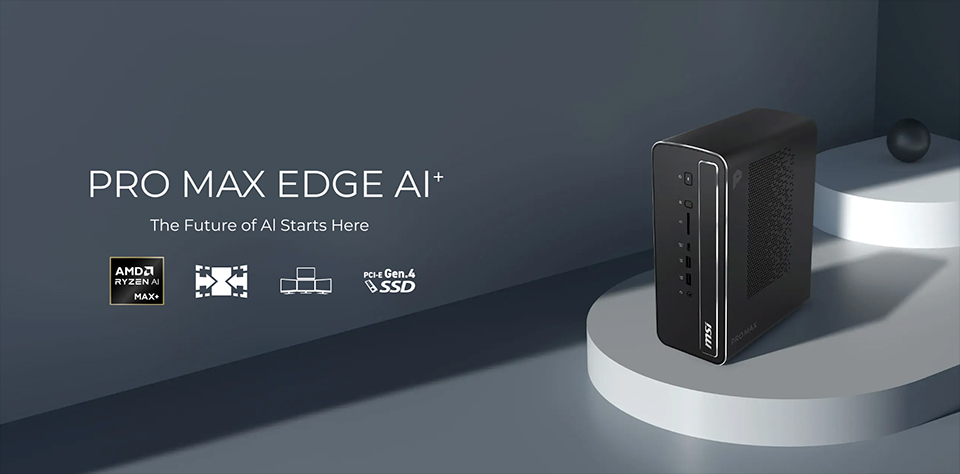
تم تصميم جهاز إم إس آي PRO MAX EDGE AI+ خصيصًا لتطبيقات الذكاء الاصطناعي التنفيذي. بفضل تزويده بمعالج AMD Ryzen AI Max+ 395 المدمج، فإنه مجهز بالكامل لتشغيل نماذج اللغة الكبيرة (LLMs) وتلبية متطلبات برامج الذكاء الاصطناعي المتقدمة. ومع ذاكرة موحدة تصل إلى 128 جيجابايت، فإنه قادر على تشغيل نماذج ضخمة تصل إلى 120B معلمة "متغير" محليًا بسرعة تتجاوز 30 رمزًا في الثانية (Tokens/s)، مما يوفر أوقات استجابة فائقة السرعة.
نموذج اللغة الضخم (LLM)
استهلاك VRAM
متوسط TPS (رمز/ثانية)
Gemma4 E4B
9.6GB
50.51
Gemma4 12B
7.6GB
23.24
GPT-OSS 20B
13GB
44.36
Gemma4 26B
17GB
51.85
Qwen 3.6 35B
23GB
58.96
GPT-OSS 120B
65GB
33.29
جدول أداء PRO MAX Edge AI+ LLM.
وإلى جانب أعباء عمل الذكاء الاصطناعي، يتعامل كارت الشاشة المدمج Radeon 8060S مع ألعاب بدقة 2K بكل سهولة. هل تنتابك المخاوف بشأن اختناق الأداء الحراري في هيكل مدمج؟ قامت MSI بتصميم نظام تبريد مخصص بثلاث مراوح ومشتت حراري من النحاس النقي لضمان تشغيل النظام ببرودة واستقرار تامين. ويتناسب حجمه المدمج بسهولة مع أي مساحة عمل. انقر هنا لمعرفة المزيد حول MSI PRO MAX Edge AI+.
PRO MAX Edge AI+: https://www.msi.com/Business-Productivity-PC/PRO-MAX-EDGE-AI-Plus-11M